


Qwen 3.8 Flash Next resmi menjadi senjata terbaru Alibaba dalam merespons sengitnya perang harga industri kecerdasan buatan (AI) antara penyedia teknologi China dan Amerika Serikat.
Meluncur secara global pada Kamis (27/8/2026), varian teranyar ini tidak sekadar ikut-ikutan meramaikan pasar LLM (Large Language Model). Model ini dirancang secara spesifik untuk memfasilitasi perusahaan yang mendambakan asisten virtual dan agen otomatis cerdas, namun terhalang oleh mahalnya biaya komputasi.
Sebagai pratinjau awal dari arsitektur generasi keempat (Qwen 4) yang akan datang, model multimodal ini membawa terobosan rekayasa yang sangat unik.
Alih-alih membakar memori perangkat keras secara membabi buta, arsitekturnya dimodifikasi agar sanggup berjalan dengan sangat ringan, menjadikannya salah satu opsi paling mematikan bagi kompetitor di kelas kecerdasan buatan berlisensi terbuka (open weight).
Lantas, seperti apa trik efisiensi silikon yang ditawarkan Alibaba dan bagaimana performanya saat diadu dengan model raksasa lainnya?
Arsitektur Pakar dan Manipulasi RAM
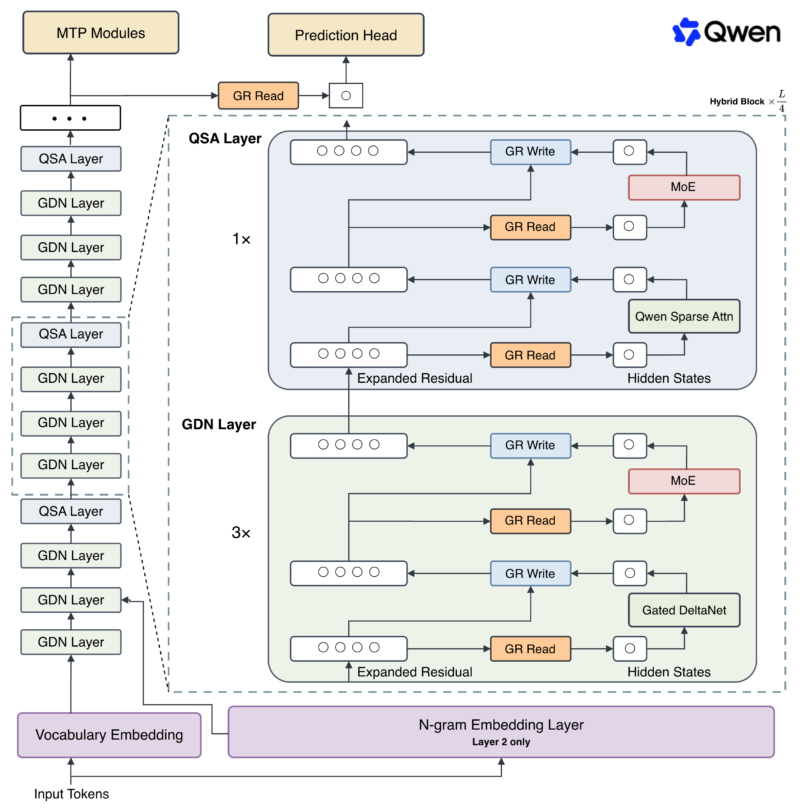
Pusat dari efisiensi ekstrem model ini terletak pada penggunaan arsitektur Mixture-of-Experts (MoE). Di atas kertas, sistem ini mengusung kapasitas raksasa sebesar 125 miliar parameter.
Namun berkat sistem MoE, hanya sekitar 6 miliar parameter saja yang berstatus aktif saat mesin memproses setiap kepingan kata (token). Kondisi ini sangat jauh berbeda dibandingkan “kakaknya”, Qwen 3.8 Max, yang memikul beban utuh 2,4 triliun parameter setiap saat.
Inovasi rekayasa paling revolusioner lainnya adalah penyematan lapisan N-gram embedding yang memuat 51 miliar parameter. Lapisan ini berfungsi layaknya sebuah “kamus” pintar yang menyimpan kelompok kata paling umum digunakan oleh manusia.
Hebatnya, pangkalan data kamus raksasa tersebut bisa ditempatkan murni di dalam memori sementara (RAM) sistem komputer, tanpa harus disuntikkan ke dalam memori kartu grafis (VRAM) GPU yang harganya sangat mahal.
Dukungan teknis bawaannya juga sangat memanjakan pengembang aplikasi. Jendela konteksnya sanggup menelan 262.144 token sekaligus, dan bisa diekspansi secara paksa hingga kapasitas 1 juta token dengan memanfaatkan metode YaRN.
Dominasi Benchmark dan Pekerjaan Profesional
Biaya komputasi yang ditekan sedemikian rupa rupanya tidak menyunat kecerdasannya. Model ini difokuskan penuh untuk menaklukkan skenario penggunaan tingkat perusahaan, seperti mengoperasikan agen AI, berinteraksi dengan API yang rumit, mengakses basis data eksternal, hingga menggunakan kalkulator digital melalui perintah teks maupun visual.
Alibaba bahkan mengeklaim bahwa biaya pelatihan dan inferensi model ini sembilan kali lebih murah jika disandingkan dengan Qwen 3.7-Plus. Meski sangat hemat, kemampuannya dalam memecahkan struktur pemrograman (coding) justru meroket.
Berdasarkan pengujian teknis yang dipublikasikan secara resmi, model ini mencetak skor 58,7 pada DeepSWE dan 62,5 pada SWE-bench Pro—dua tolak ukur standar industri untuk menguji kehebatan AI dalam mendeteksi dan menambal celah bug pada proyek software.
Ketajamannya dalam menangani pekerjaan perkantoran juga tidak bisa dipandang sebelah mata. Pada platform CoWorkBench, model ini membukukan skor impresif 73,9, jauh meninggalkan DeepSeek-V4-Flash yang terpuruk di angka 45,1.
Sementara pada pengujian JobBench yang mensimulasikan alur kerja profesional, skornya mencapai 55,7, naik hampir dua kali lipat dari Qwen 3.7-Plus. Dalam berbagai parameter tersebut, kemampuan sistem ini secara konsisten mengasapi model-model elit lainnya, termasuk Claude Opus 4.6 besutan Anthropic.
Banting Harga Ekstrem di Pasar Terbuka
Demi mempercepat adopsi massal, Alibaba mematok harga sewa yang dipastikan membuat kompetitornya ketar-ketir. Akses ke model ini hanya dihargai 0,16 dolar AS (sekitar Rp 2.838) per 1 juta token input, dan 0,47 dolar AS (sekitar Rp 8.337) per 1 juta token output.
Angka ini bagaikan bumi dan langit jika dibandingkan dengan tarif Qwen 3.8 Max yang menyentuh 2 dolar AS untuk input dan 6 dolar AS untuk output.
Tidak hanya murah, status model ini adalah open weight, sangat bertolak belakang dengan sistem tertutup (proprietary) yang diterapkan oleh OpenAI. Berkas utuhnya bisa diunduh secara bebas oleh komunitas pengembang melalui repositori Hugging Face dan ModelScope.
Menurut analis senior Gartner, Arun Chandrasekaran, status transparan yang dipadukan dengan efisiensi inferensi tinggi inilah yang membuat biaya komputasinya bisa ditekan hingga ke titik terendah.
Persaingan ekosistem kecerdasan buatan berbiaya rendah ini jelas membuka peluang inovasi yang tidak terbatas bagi kalangan perusahaan rintisan maupun pengembang independen.
Untuk terus memantau rilis terbaru dari platform Hugging Face, perbandingan akurasi benchmark AI global, hingga berita peluncuran perangkat keras penunjang produktivitas, pastikan untuk selalu menelusuri artikel mendalam lainnya hanya di Dafunda Tekno.
FAQ
1. Apa perbedaan Qwen 3.8 Flash Next dengan model AI lainnya?
Ini adalah model AI beraliran Mixture-of-Experts (MoE) yang dirancang untuk efisiensi ekstrem. Meski memiliki 125 miliar parameter, sistem ini hanya mengaktifkan sekitar 6 miliar parameter saat memproses perintah, sehingga jauh lebih cepat dan murah saat dioperasikan.
2. Berapa harga operasional dari model AI ini?
Alibaba mematok tarif yang sangat agresif, yakni hanya 0,16 dolar AS untuk setiap 1 juta token input dan 0,47 dolar AS untuk setiap 1 juta token output, menjadikannya sangat bersahabat bagi perusahaan rintisan.
3. Di mana pengembang bisa mendapatkan berkas model ini?
Sebagai sistem berlisensi open weight, seluruh berkas dan bobot hasil pelatihan dari model terbaru Alibaba ini telah tersedia secara gratis di repositori terbuka seperti Hugging Face dan ModelScope.
4. Apakah model yang murah ini mampu digunakan untuk coding?
Sangat mumpuni. Meski dirancang hemat biaya, model ini justru mencetak skor sangat tinggi pada pengujian standar industri perangkat lunak seperti DeepSWE dan SWE-bench Pro, bahkan diklaim mampu mengungguli pesaing kelas atas seperti Claude Opus 4.6 dalam tugas perkantoran.

Bales ke